주요 콘텐츠

이 번역 페이지는 최신 내용을 담고 있지 않습니다. 최신 내용을 영문으로 보려면 여기를 클릭하십시오.

std

R2026a

설명

S = std(A)는 크기가 1이 아닌 첫 번째 배열 차원에서 A의 요소의 표준편차를 반환합니다. 기본적으로, 표준편차는 N-1으로 정규화됩니다. 여기서 N은 관측값의 개수입니다.

  • A가 관측값으로 구성된 벡터인 경우 S는 스칼라입니다.

  • A가 열이 확률 변수이고 행이 관측값인 행렬인 경우, S는 각 열에 대응하는 표준편차가 포함된 행 벡터입니다.

  • A가 다차원 배열인 경우 std(A)는 크기가 1이 아닌 첫 번째 배열 차원을 따라 연산을 수행하며, 요소를 벡터로 취급합니다. 이 차원에서 S의 크기는 1이 되고 다른 모든 차원의 크기는 A와 동일합니다.

  • A가 스칼라인 경우 S는 0입니다.

  • A가 0×0의 빈 배열이면 S는 NaN이 됩니다.

  • A가 테이블 또는 타임테이블인 경우 std(A)는 각 변수의 표준편차를 포함하는 한 행 크기의 테이블을 반환합니다. (R2023a 이후)

예제

S = std(A,w)는 가중치 부여 방식을 지정합니다. w = 0일 때(기본값임), 표준편차는 N-1로 정규화됩니다. 여기서 N은 관측값의 개수입니다. w = 1인 경우, 표준편차는 관측값 개수로 정규화됩니다. w는 음이 아닌 요소를 포함하는 가중 벡터일 수도 있습니다. 이 경우 w의 길이는 std가 동작을 수행하는 차원의 길이와 같아야 합니다.

예제

S = std(A,w,"all")은 w가 0 또는 1인 경우 A의 모든 요소에 대한 표준편차를 반환합니다.

S = std(A,w,dim)은 차원 dim을 따라 표준편차를 반환합니다. 연산 차원을 지정하는 동안 디폴트 정규화를 유지하려면 두 번째 인수에 w = 0을 설정하십시오.

예제

S = std(A,w,vecdim)은 w가 0 또는 1인 경우 벡터 vecdim에 지정된 차원에 대한 표준편차를 반환합니다. 예를 들어, A가 행렬인 경우 std(A,0,[1 2])는 차원 1과 2로 정의된 배열 슬라이스에 행렬의 모든 요소가 포함되어 있으므로 A의 모든 요소에 대한 표준편차를 반환합니다.

예제

S = std(___,missingflag)는 위에 열거된 구문에 대해 A의 누락값을 포함시킬지 또는 생략할지 여부를 지정합니다. 예를 들어, std(A,"omitmissing")은 표준편차를 구할 때 모든 누락값을 무시합니다. 기본적으로 std는 누락값을 포함합니다.

예제

[S,M] = std(___)는 표준편차 계산에 사용된 A의 요소 평균도 반환합니다. S가 가중 표준편차이면 M은 가중 평균입니다.

예제

예제

모두 축소

행렬을 만든 다음 각 열의 표준편차를 계산합니다.

A = [4 -5 1; 2 3 5; -9 1 7];
S = std(A)
S = 1×3

    7.0000    4.1633    3.0551

3차원 배열을 만든 다음 첫 번째 차원을 따라 표준편차를 계산합니다.

A(:,:,1) = [2 4; -2 1];
A(:,:,2) = [9 13; -5 7];
A(:,:,3) = [4 4; 8 -3];
S = std(A)
S = 
S(:,:,1) =

    2.8284    2.1213


S(:,:,2) =

    9.8995    4.2426


S(:,:,3) =

    2.8284    4.9497

행렬을 만든 다음 가중 벡터 w에 따라 각 열의 표준편차를 계산합니다.

A = [1 5; 3 7; -9 2];
w = [1 1 0.5];
S = std(A,w)
S = 1×2

    4.4900    1.8330

행렬을 만든 다음 각 행을 따라 표준편차를 계산합니다.

A = [6 4 23 -3; 9 -10 4 11; 2 8 -5 1];
S = std(A,0,2)
S = 3×1

   11.0303
    9.4692
    5.3229

3차원 배열을 만들고 데이터의 각 페이지(행과 열)에 대한 표준편차를 구합니다.

A(:,:,1) = [2 4; -2 1];
A(:,:,2) = [9 13; -5 7];
A(:,:,3) = [4 4; 8 -3];
S = std(A,0,[1 2])
S = 
S(:,:,1) =

    2.5000


S(:,:,2) =

    7.7460


S(:,:,3) =

    4.5735

NaN 값이 포함된 행렬을 만듭니다.

A = [1.77 -0.005 NaN -2.95; NaN 0.34 NaN 0.19]
A = 2×4

    1.7700   -0.0050       NaN   -2.9500
       NaN    0.3400       NaN    0.1900

누락값을 제외하고 행렬의 표준편차를 구합니다. NaN 값이 포함된 행렬 열의 경우 std는 NaN이 아닌 요소에 대해 계산을 수행합니다. 값이 모두 NaN인 A의 열의 경우 표준편차는 NaN이 됩니다.

S = std(A,"omitmissing")
S = 1×4

         0    0.2440       NaN    2.2203

R2023a 이전: 누락값을 무시하려면 "omitnan" 또는 "omitnat"를 사용합니다.

행렬을 만든 다음 각 열의 표준편차와 평균을 계산합니다.

A = [4 -5 1; 2 3 5; -9 1 7];
[S,M] = std(A)
S = 1×3

    7.0000    4.1633    3.0551

M = 1×3

   -1.0000   -0.3333    4.3333

행렬을 만든 다음 가중 벡터 w에 따라 각 열의 가중 표준편차 및 가중 평균을 계산합니다.

A = [1 5; 3 7; -9 2];
w = [1 1 0.5];
[S,M] = std(A,w)
S = 1×2

    4.4900    1.8330

M = 1×2

   -0.2000    5.2000

입력 인수

모두 축소

입력 배열로, 벡터, 행렬, 다차원 배열, table형 또는 timetable형으로 지정됩니다. A가 스칼라이면 std(A)는 0을 반환합니다. A가 0×0의 빈 배열인 경우, std(A)는 NaN을 반환합니다.

데이터형: single | double | datetime | duration | table | timetable
복소수 지원 여부: 예

가중치로, 다음 값 중 하나로 지정됩니다.

  • 0 — N-1로 정규화합니다. 여기서 N은 관측값의 개수입니다. 관측값이 하나만 있는 경우 가중치는 1입니다.

  • 1 — N으로 정규화합니다.

  • 음이 아닌 스칼라로 구성된 벡터는 표준편차가 계산되는 A의 대응하는 차원에 따라 가중됩니다.

데이터형: single | double

연산을 수행할 차원으로, 양의 정수 스칼라로 지정됩니다. 차원을 지정하지 않을 경우, 디폴트 값은 크기가 1이 아닌 첫 번째 배열 차원이 됩니다.

차원 dim은 길이가 1로 줄어드는 차원을 나타냅니다. size(S,dim)은 1이 되고, 다른 모든 차원의 크기는 변경되지 않습니다.

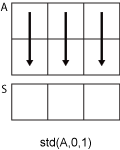
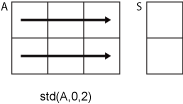
m×n 입력 행렬 A가 있다고 가정합니다.

  • std(A,0,1)은 A의 각 열에서 요소들의 표준편차를 구하고, 1×n 행 벡터를 반환합니다.

    std(A,0,1) column-wise computation

  • std(A,0,2)는 A의 각 행에서 요소들의 표준편차를 구하고, m×1 열 벡터를 반환합니다.

    std(A,0,2) row-wise computation

dim이 ndims(A)보다 큰 경우 std(A)는 A와 크기가 같은, 0으로 구성된 배열을 반환합니다.

차원의 벡터로, 양의 정수로 구성된 벡터로 지정됩니다. 각 요소는 입력 배열의 차원을 나타냅니다. 지정된 연산 차원의 출력값의 길이는 1이고, 다른 모든 차원의 길이는 변경되지 않습니다.

2×3×3 입력 배열 A가 있다고 가정하겠습니다. 이때 std(A,0,[1 2])는 A의 각 페이지에 대해 구한 표준편차를 요소로 갖는 1×1×3 배열을 반환합니다.
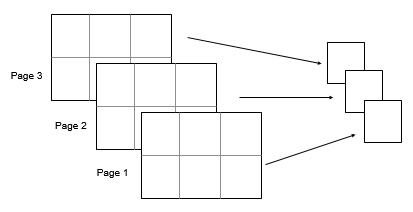
Mapping of a 2-by-3-by-3 input array to a 1-by-1-by-3 output array

누락값 조건으로, 다음 표에 있는 값 중 하나로 지정됩니다.

값입력 데이터형설명
"includemissing" (R2023a 이후)지원되는 모든 데이터형

표준편차를 구할 때 A와 w의 누락값을 포함합니다. 연산 차원의 요소가 하나라도 누락값인 경우 이에 대응하는 S의 요소도 누락값입니다.

"includenan"double, single, duration
"includenat"datetime
"omitmissing" (R2023a 이후)지원되는 모든 데이터형A와 w의 누락값을 무시하고, 더 적은 수의 점을 대상으로 표준편차를 계산합니다. 연산 차원의 요소가 누락값인 경우 이에 대응하는 S의 요소도 누락값입니다.
"omitnan"double, single, duration
"omitnat"datetime

출력 인수

모두 축소

표준편차로, 스칼라, 벡터, 행렬, 다차원 배열 또는 테이블로 반환됩니다.

  • A가 관측값으로 구성된 벡터인 경우 S는 스칼라입니다.

  • A가 열이 확률 변수이고 행이 관측값인 행렬인 경우, S는 각 열에 대응하는 표준편차가 포함된 행 벡터입니다.

  • A가 다차원 배열인 경우 std(A)는 크기가 1이 아닌 첫 번째 배열 차원을 따라 연산을 수행하며, 요소를 벡터로 취급합니다. 이 차원에서 S의 크기는 1이 되고 다른 모든 차원의 크기는 A와 동일합니다.

  • A가 스칼라인 경우 S는 0입니다.

  • A가 0×0의 빈 배열이면 S는 NaN이 됩니다.

  • A가 테이블 또는 타임테이블이면 S는 행이 한 개 있는 테이블입니다. (R2023a 이후)

평균값으로, 스칼라, 벡터, 행렬, 다차원 배열 또는 테이블로 반환됩니다.

  • A가 관측값으로 구성된 벡터인 경우 M은 스칼라입니다.

  • A가 열이 확률 변수이고 행이 관측값인 행렬인 경우, M은 각 열에 대응하는 평균이 포함된 행 벡터입니다.

  • A가 다차원 배열인 경우 std(A)는 크기가 1이 아닌 첫 번째 배열 차원을 따라 연산을 수행하며, 요소를 벡터로 취급합니다. 이 차원에서 M의 크기는 1이 되고 다른 모든 차원의 크기는 A와 동일합니다.

  • A가 스칼라인 경우 M은 A와 동일합니다.

  • A가 0×0의 빈 배열이면 M은 NaN이 됩니다.

  • A가 테이블 또는 타임테이블이면 M은 행이 한 개 있는 테이블입니다. (R2023a 이후)

S가 가중 표준편차이면 M은 가중 평균입니다.

세부 정보

모두 축소

확장 기능

모두 확장

버전 내역

R2006a 이전에 개발됨

모두 확장

참고 항목

| | | | |