딥러닝을 사용한 sequence-to-sequence 회귀
R2026b이 예제에서는 딥러닝을 사용하여 엔진의 잔여 수명(RUL)을 예측하는 방법을 보여줍니다.
시계열 또는 시퀀스 데이터로부터 숫자형 값을 예측하도록 심층 신경망을 훈련시키기 위해 장단기 기억(LSTM) 신경망을 사용할 수 있습니다.
이 예제에서는 [1]에서 설명한 Turbofan Engine Degradation Simulation Data Set를 사용합니다. 이 예제에서는 엔진의 여러 센서를 나타내는 시계열 데이터를 준 다음, 예측 정비 관점에서 엔진의 잔여 수명(단위: 주기)을 예측하도록 LSTM 신경망을 훈련시킵니다. 훈련 데이터는 엔진 100개의 시뮬레이션된 시계열 데이터를 포함합니다. 각 시퀀스는 길이가 다양하며, 하나의 완전한 RTF(run to failure) 인스턴스에 대응됩니다. 테스트 데이터는 100개의 부분 시퀀스를 포함합니다. 각 시퀀스의 마지막에는 잔여 수명에 대응되는 값이 포함됩니다.
데이터 세트는 100개의 훈련 관측값과 100개의 테스트 관측값을 포함합니다.
데이터 다운로드하기
Turbofan Engine Degradation Simulation 데이터 세트를 다운로드하고 압축을 풉니다.
Turbofan Engine Degradation Simulation 데이터 세트의 각 시계열은 서로 다른 엔진을 나타냅니다. 각 엔진은 알려지지 않은 초기 마모 및 제작 편차가 있는 상태에서 구동되기 시작합니다. 각 시계열의 시작 시에 엔진은 정상적으로 동작하며, 시계열의 어느 시점에서 결함이 발생합니다. 훈련 세트에서 결함의 크기는 시스템 결함이 발생할 때까지 커집니다.
데이터는 공백으로 구분된 26개 숫자 열의 형태로 압축 텍스트 파일에 들어 있습니다. 각 행은 1회의 동작 주기 동안 캡처한 데이터 스냅샷이고, 각 열은 다른 변수입니다. 열은 다음에 대응됩니다.
1열 – 유닛 번호
2열 – 시간(단위: 주기)
3–5열 – 동작 설정
6–26열 – 센서 측정값 1–21
Turbofan Engine Degradation Simulation 데이터 세트를 저장할 디렉터리를 만듭니다.
dataFolder = fullfile(tempdir,"turbofan");
if ~exist(dataFolder,"dir")
    mkdir(dataFolder);
end
Turbofan Engine Degradation Simulation 데이터 세트를 다운로드하고 추출합니다.
filename = matlab.internal.examples.downloadSupportFile("nnet","data/TurbofanEngineDegradationSimulationData.zip");
unzip(filename,dataFolder)
훈련 데이터 준비하기
이 예제에 첨부된 함수 processTurboFanDataTrain을 사용하여 데이터를 불러옵니다. 함수 processTurboFanDataTrain은 filenamePredictors에서 데이터를 추출하고, 훈련 예측 변수 시퀀스와 응답 변수 시퀀스를 포함하는 셀형 배열 XTrain과 TTrain을 반환합니다.
filenamePredictors = fullfile(dataFolder,"train_FD001.txt");
[XTrain,TTrain] = processTurboFanDataTrain(filenamePredictors);
상수 값을 갖는 특징 제거하기
모든 시간 스텝에 대해 변하지 않는 특징은 훈련의 성능을 저하할 수 있습니다. 동일한 최솟값과 최댓값을 갖는 데이터 열을 찾아서 제거합니다.
XTrainConcatenatedTimesteps = cat(1,XTrain{:});
m = min(XTrainConcatenatedTimesteps,[],1);
M = max(XTrainConcatenatedTimesteps,[],1);
idxConstant = M == m;

for i = 1:numel(XTrain)
    XTrain{i}(:,idxConstant) = [];
end
시퀀스에 남아 있는 특징의 개수를 봅니다.
numFeatures = size(XTrain{1},2)numFeatures = 17
정규화 통계량 계산하기
이 예제의 신경망은 시퀀스 입력 계층을 사용하며, 이 계층은 자동으로 계산된 정규화 통계량을 사용하여 입력 데이터를 정규화하는 것을 지원합니다. 이 예제에서 사용되는 훈련 시퀀스의 길이가 서로 다르므로, 각 미니 배치 내 시퀀스 길이가 같아지도록 0으로 채워집니다. 채우기에 대응하는 0 값 요소는 정규화 통계량 계산에 부정적인 영향을 미칠 수 있으므로, 대신 통계량을 수동으로 계산하십시오.
모든 관측값에 대해 평균과 표준편차를 계산하려면 시퀀스 데이터를 가로로 결합하십시오.
XTrainConcatenatedTimesteps = cat(1,XTrain{:});
mu = mean(XTrainConcatenatedTimesteps,1);
sig = std(XTrainConcatenatedTimesteps,0,1);
응답 변수 자르기
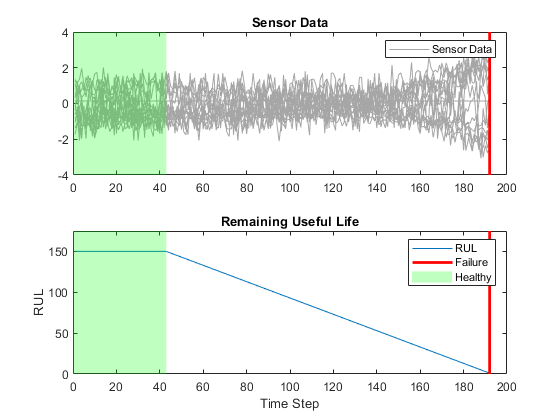
엔진 결함이 임박했을 때 시퀀스 데이터로부터 더 많이 학습할 수 있도록 응답 변수를 임계값 150에서 자르십시오. 이렇게 하면 신경망이 이보다 더 높은 RUL 값을 갖는 인스턴스들을 동일하게 처리합니다.
thr = 150;
for i = 1:numel(TTrain)
    TTrain{i}(TTrain{i} > thr) = thr;
end
이 그림에서는 첫 번째 관측값과 여기에 대응하는 잘린 응답 변수를 보여줍니다.
신경망 아키텍처 정의하기
다음과 같이 신경망 아키텍처를 정의합니다.
수동으로 계산된 정규화 통계량을 사용하여 -점수 정규화를 적용하는 시퀀스 입력 계층을 지정합니다.
LSTM 계층의 경우 200개의 은닉 유닛을 지정합니다.
출력 크기가 50인 완전 연결 계층과 그 뒤에 이어지는 드롭아웃 확률 0.5의 드롭아웃 계층을 포함합니다.
회귀의 경우, 출력 크기가 응답 변수의 개수와 일치하는 완전 연결 계층을 추가합니다.
이 예제에서 훈련 프로세스는
NormalizeTargets훈련 옵션(R2026a에서 추가됨)을 사용하여 훈련 목표값을 자동으로 정규화합니다. 정규화된 목표값을 사용하면 훈련을 안정화하고 정규화된 목표값과 거의 일치하는 훈련 예측값을 얻는 데 도움이 됩니다. 신경망이 예측 시점에서만 정규화되지 않은 값의 공간에서 예측값을 출력하도록 하려면 대칭 재스케일링의 역 연산을 적용하는 역정규화 계층(R2026a에서 추가됨)을 포함하십시오. R2026a 이전: 훈련을 안정화하려면 목표값을 수동으로 정규화한 다음 신경망을 훈련시키십시오.
numHiddenUnits = 200;
fcOutputSize = 50;
dropoutProbability = 0.5;

numResponses = size(TTrain{1},2);

layers = [ ...
    sequenceInputLayer(numFeatures,Normalization="zscore",Mean=mu',StandardDeviation=sig')
    lstmLayer(numHiddenUnits,OutputMode="sequence")
    fullyConnectedLayer(fcOutputSize)
    dropoutLayer(dropoutProbability)
    fullyConnectedLayer(numResponses)
    inverseNormalizationLayer(Normalization="rescale-symmetric")];
목표값은 하한이 0이고 상한이 자르기 임계값이므로 0으로 채워진 목표값은 재스케일링에 사용되는 목표값 정규화 통계량에 영향을 미치지 않습니다.
훈련 옵션 지정하기
훈련 옵션을 지정합니다. 옵션 중에서 선택하려면 경험적 분석이 필요합니다. 실험을 실행하여 다양한 훈련 옵션 구성을 살펴보려면 실험 관리자 앱을 사용합니다.
Adam 솔버를 사용하여 훈련시킵니다.
NormalizeTargets인수(R2026a에서 추가됨)를 사용하여 훈련 목표값을 자동으로 정규화합니다. R2026a 이전: 훈련을 안정화하려면 목표값을 수동으로 정규화한 다음 신경망을 훈련시키십시오.입력 계층의 정규화 통계량을 재설정하지 마십시오.
시퀀스의 왼쪽을 채웁니다.
크기가 20인 미니 배치로 Epoch 80회만큼 훈련을 진행합니다.
기울기가 한없이 증가하지 않도록 하려면 기울기 임계값을 1로 설정하십시오.
매 Epoch마다 시퀀스를 섞습니다.
훈련 진행 상황을 플롯으로 표시하고 RMSE(RMS 오차) 메트릭을 모니터링합니다.
상세 출력값을 비활성화합니다.
maxEpochs = 80;
miniBatchSize = 20;

options = trainingOptions("adam", ...
    NormalizeTargets=true, ...
    ResetInputNormalization=false, ...
    SequencePaddingDirection="left", ...
    MaxEpochs=maxEpochs, ...
    MiniBatchSize=miniBatchSize, ...
    GradientThreshold=1, ...
    Shuffle="every-epoch", ...
    Plots="training-progress", ...
    Metrics="rmse", ...
    Verbose=false);
신경망 훈련시키기
trainnet 함수를 사용하여 신경망을 훈련시킵니다. 회귀의 경우, 평균제곱오차(MSE) 손실을 사용합니다. 기본적으로 trainnet 함수는 GPU를 사용할 수 있으면 GPU를 사용합니다. GPU를 사용하려면 Parallel Computing Toolbox™ 라이선스와 지원되는 GPU 장치가 필요합니다. 지원되는 장치에 대한 자세한 내용은 GPU 연산 요구 사항 (Parallel Computing Toolbox) 항목을 참조하십시오. GPU를 사용할 수 없는 경우, 함수는 CPU를 사용합니다. 실행 환경을 수동으로 선택하려면 ExecutionEnvironment 훈련 옵션을 사용하십시오.
net = trainnet(XTrain,TTrain,layers,"mse",options);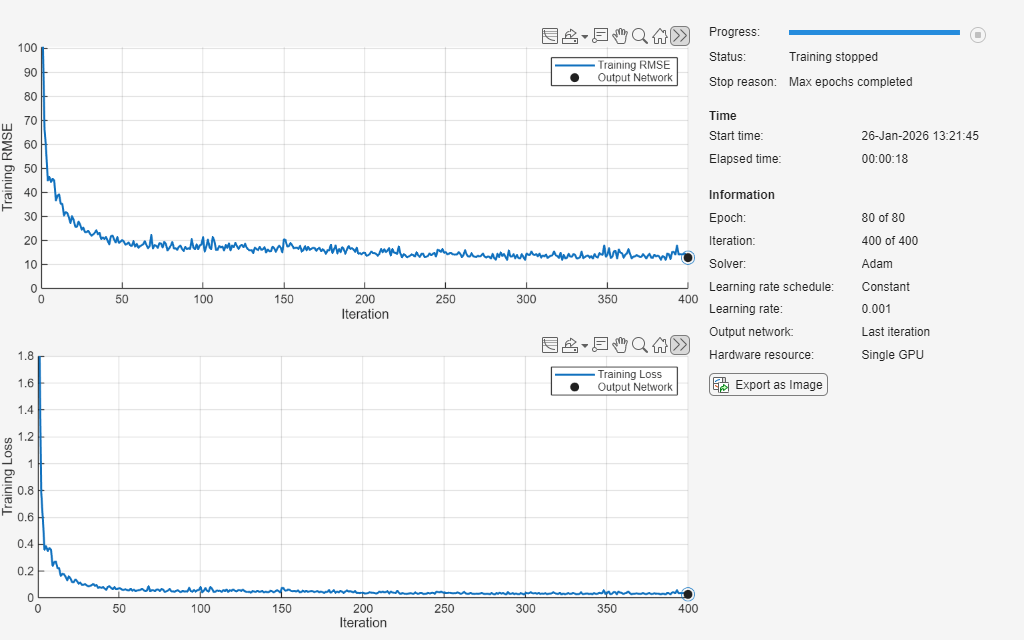
신경망 테스트하기
이 예제에 첨부된 함수 processTurboFanDataTest를 사용하여 테스트 데이터를 준비합니다. 함수 processTurboFanDataTest는 filenamePredictors와 filenameResponses에서 데이터를 추출하고, 각각 훈련 예측 변수 시퀀스와 응답 변수 시퀀스를 포함하는 셀형 배열 XTest와 TTest를 반환합니다.
filenamePredictors = fullfile(dataFolder,"test_FD001.txt");
filenameResponses = fullfile(dataFolder,"RUL_FD001.txt");
[XTest,TTest] = processTurboFanDataTest(filenamePredictors,filenameResponses);
훈련 데이터로부터 계산한 idxConstant를 사용하여 상수 값을 갖는 특징을 제거합니다. 훈련 데이터에 사용된 임계값과 동일한 임계값에서 테스트 응답 변수를 자릅니다.
for i = 1:numel(XTest)
    XTest{i}(:,idxConstant) = [];
    TTest{i}(TTest{i} > thr) = thr;
end
신경망을 사용하여 예측을 수행합니다. 여러 개의 관측값을 사용하여 예측을 수행하려면 minibatchpredict 함수를 사용합니다. minibatchpredict 함수는 GPU를 사용할 수 있으면 자동으로 GPU를 사용합니다. GPU를 사용하려면 Parallel Computing Toolbox™ 라이선스와 지원되는 GPU 장치가 필요합니다. 지원되는 장치에 대한 자세한 내용은 GPU 연산 요구 사항을 참조하십시오. GPU를 사용할 수 없는 경우, 함수는 CPU를 사용합니다. 함수가 데이터에 채우기를 추가하지 않도록 하려면 미니 배치 크기를 1로 지정하십시오. 예측값을 셀형 배열로 반환하려면 UniformOutput을 false로 설정하십시오.
YTest = minibatchpredict(net,XTest, ...
    MiniBatchSize=1, ...
    UniformOutput=false);
LSTM 신경망은 한 번에 시간 스텝 하나씩 부분 시퀀스에 대해 예측을 수행합니다. 각 시간 스텝마다 신경망은 이번 시간 스텝의 값과 이전 시간 스텝들로부터 계산한 신경망 상태만을 사용하여 예측을 수행합니다. 신경망은 각 예측 사이에 신경망 상태를 업데이트합니다. minibatchpredict 함수는 이러한 예측으로 구성된 시퀀스를 반환합니다. 예측의 마지막 요소는 해당 부분 시퀀스에 대해 예측된 RUL에 대응합니다.
또는 predict를 사용하고 신경망의 State 속성을 업데이트하여 한 번에 시간 스텝 하나씩 예측을 수행할 수도 있습니다. 이 방법은 시간 스텝의 값이 스트림으로 수신되는 경우에 유용합니다. 일반적으로 한 번에 시간 스텝 하나씩 예측을 수행하는 것보다 전체 시퀀스에 대해 예측을 수행하는 것이 빠릅니다. 단일 시간 스텝 예측들 사이에서 신경망을 업데이트하여 미래의 시간 스텝을 전망하는 방법에 대한 예제는 딥러닝을 사용한 시계열 전망 항목을 참조하십시오.
예측 중 일부를 플롯으로 시각화합니다.
idx = randperm(numel(YTest),4);
figure
for i = 1:numel(idx)
    subplot(2,2,i)

    plot(TTest{idx(i)},"--")
    hold on
    plot(YTest{idx(i)},".-")
    hold off

    ylim([0 thr + 25])
    title("Test Observation " + idx(i))
    xlabel("Time Step")
    ylabel("RUL")
end
legend(["Test Data" "Predicted"],Location="southeast")
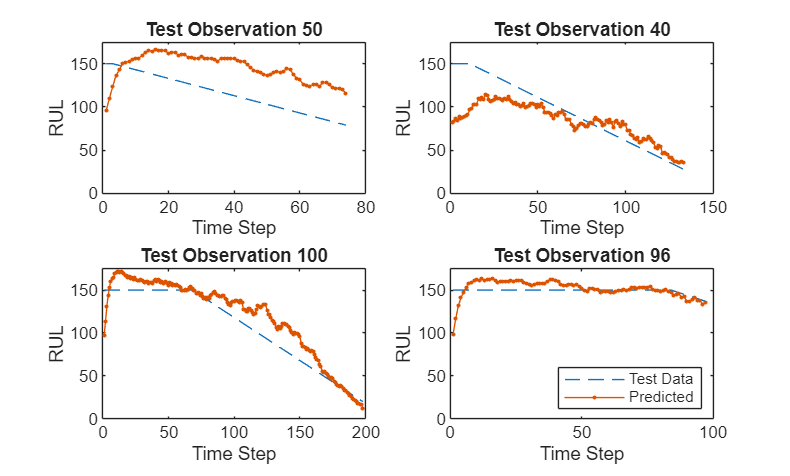
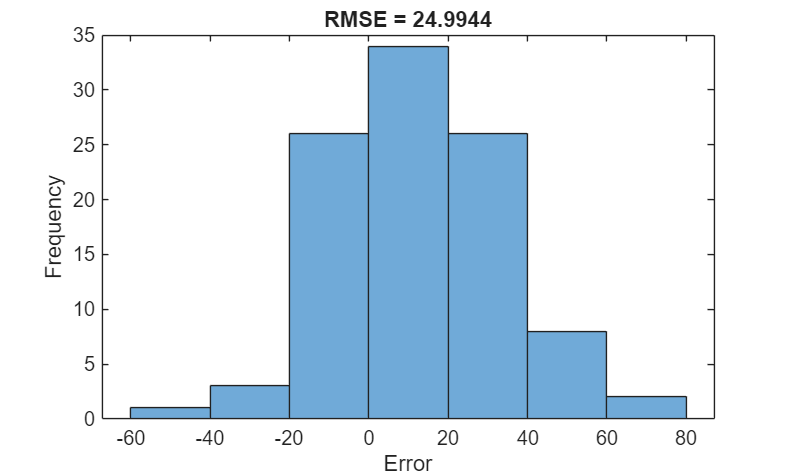
주어진 부분 시퀀스에서 예측된 현재 RUL은 예측된 시퀀스의 마지막 요소입니다. 예측의 RMSE를 계산하고, 예측 오차를 히스토그램으로 시각화합니다.
for i = 1:numel(TTest)
    TTestLast(i) = TTest{i}(end);
    YTestLast(i) = YTest{i}(end);
end
figure
err = sqrt(mean((YTestLast - TTestLast).^2))
err = single

24.9944
histogram(YTestLast - TTestLast)
title("RMSE = " + err)
ylabel("Frequency")
xlabel("Error")
참고 문헌
Saxena, Abhinav, Kai Goebel, Don Simon, and Neil Eklund. "Damage propagation modeling for aircraft engine run-to-failure simulation." In Prognostics and Health Management, 2008. PHM 2008. International Conference on, pp. 1-9. IEEE, 2008.
참고 항목
trainnet | trainingOptions | dlnetwork | testnet | minibatchpredict | scores2label | predict | lstmLayer | sequenceInputLayer

