forward
R2026b훈련에 사용할 딥러닝 신경망 출력값 계산
구문
설명
일부 딥러닝 계층은 훈련 중과 추론(예측) 중에 서로 다르게 동작합니다. 예를 들어, 훈련 중에는 드롭아웃 계층이 과적합 방지를 돕기 위해 입력 요소를 임의로 0으로 설정하지만, 추론 중에는 드롭아웃 계층이 입력값을 변경하지 않습니다. 이와 유사하게, 배치 정규화 계층은 훈련 중에는 미니 배치 통계량을 사용하여 정규화하지만, 추론 중에는 훈련된 평균 및 분산을 사용합니다.
훈련에 사용할 신경망 출력값을 계산하려면 forward 함수를 사용하십시오. 추론에 사용할 신경망 출력값을 계산하려면 predict 함수를 사용하십시오.
[은 가지치기 계층의 활성화로 구성된 셀형 배열도 반환합니다. 이 구문은 Y1,...,YN,state,pruningActivations] = forward(net,X1,...,XM)net이 TaylorPrunableNetwork 객체인 경우에만 적용됩니다.
심층 신경망을 가지치기하려면 Deep Learning Toolbox™ Model Compression Library 지원 패키지가 필요합니다. 이 지원 패키지는 애드온 탐색기를 사용하여 다운로드할 수 있는 무료 애드온입니다. 또는 Deep Learning Toolbox Model Compression Library 항목을 참조하십시오.
___ = forward(___,는 하나 이상의 이름-값 인수를 사용하여 추가 옵션을 지정합니다.Name=Value)
예제
이 예제에서는 사용자 지정 학습률 조정 계획을 사용하여 손으로 쓴 숫자를 분류하는 신경망을 훈련시키는 방법을 보여줍니다.
trainnet 함수와 trainingOptions 함수를 사용하여 대부분의 유형의 신경망을 훈련시킬 수 있습니다. trainingOptions 함수가 필요한 옵션을 제공하지 않는다면(예: 사용자 지정 솔버) 자동 미분을 위한 dlarray 객체와 dlnetwork 객체를 사용하여 자체 사용자 지정 훈련 루프를 정의할 수 있습니다. 사전 훈련된 딥러닝 신경망을 trainnet 함수를 사용하여 다시 훈련시키는 방법을 보여주는 예제는 새 영상 분류를 위해 신경망 다시 훈련시키기 항목을 참조하십시오.
심층 신경망을 훈련시키는 것은 최적화 작업입니다. 신경망을 함수 (가 신경망 입력값이고 가 학습 가능한 파라미터 세트임)로 취급하면, 훈련 데이터를 바탕으로 어떤 손실 값을 최소화하도록 를 최적화할 수 있습니다. 예를 들어, 주어진 입력값 와 이에 대응하는 목표값 에 대해 예측값 와 간의 오차를 최소화하도록 학습 가능한 파라미터 를 최적화할 수 있습니다.
사용되는 손실 함수는 작업의 유형에 따라 달라집니다. 예를 들면 다음과 같습니다.
분류 작업의 경우 예측값과 목표값 사이의 교차 엔트로피 오차를 최소화할 수 있습니다.
회귀 작업의 경우 예측값과 목표값 사이의 평균제곱오차를 최소화할 수 있습니다.
경사하강법을 사용하여 목적 함수를 최적화할 수 있습니다. 즉, 학습 가능한 파라미터에 대한 손실의 기울기를 사용하여 최소값으로 향하는 스텝을 취하면서 학습 가능한 파라미터 를 반복적으로 업데이트하는 방식으로 손실 을 최소화합니다. 경사하강법 알고리즘은 일반적으로 형식의 업데이트 스텝 변형을 사용하여 학습 가능한 파라미터를 업데이트합니다. 여기서 는 반복 횟수, 는 학습률, 은 기울기(학습 가능한 파라미터에 대한 손실의 도함수)입니다.
이 예제에서는 확률적 경사하강법 알고리즘(모멘텀 없음)을 사용하여 손으로 쓴 숫자를 분류하도록 신경망을 훈련시킵니다.
훈련 데이터 불러오기
imageDatastore 함수를 사용하여 숫자 데이터를 영상 데이터저장소로 불러오고 영상 데이터가 포함된 폴더를 지정합니다.
unzip("DigitsData.zip")

imds = imageDatastore("DigitsData", ...
    IncludeSubfolders=true, ...
    LabelSource="foldernames");
데이터를 훈련 세트와 테스트 세트로 분할합니다. 테스트를 위해 splitEachLabel 함수를 사용하여 데이터의 10%를 남겨 둡니다.
[imdsTrain,imdsTest] = splitEachLabel(imds,0.9,"randomize");이 예제에 사용된 신경망에는 28×28×1 크기의 입력 영상이 필요합니다. 훈련 영상의 크기를 자동으로 조정하려면 증강 영상 데이터저장소를 사용하십시오. 훈련 영상에 대해 추가로 수행할 증강 연산을 지정합니다. 즉, 가로 축 및 세로 축에서 영상을 최대 5개 픽셀만큼 임의로 평행 이동합니다. 데이터 증강은 신경망이 과적합되는 것을 방지하고 훈련 영상의 정확한 세부 정보가 기억되지 않도록 하는 데 도움이 됩니다.
inputSize = [28 28 1];
pixelRange = [-5 5];

imageAugmenter = imageDataAugmenter( ...
    RandXTranslation=pixelRange, ...
    RandYTranslation=pixelRange);

augimdsTrain = augmentedImageDatastore(inputSize(1:2),imdsTrain,DataAugmentation=imageAugmenter);
추가적인 데이터 증강을 수행하지 않고 테스트 영상의 크기를 자동으로 조정하려면 증강 영상 데이터저장소를 추가적인 전처리 연산 지정 없이 사용하십시오.
augimdsTest = augmentedImageDatastore(inputSize(1:2),imdsTest);
훈련 데이터의 클래스 개수를 확인합니다.
classes = categories(imdsTrain.Labels);
numClasses = numel(classes);
신경망 정의하기
영상 분류를 위한 신경망을 정의합니다.
영상 입력값의 경우 훈련 데이터와 일치하는 입력 크기를 갖는 영상 입력 계층을 지정합니다.
영상 입력값을 정규화하지 않도록 입력 계층의
Normalization옵션을"none"으로 설정합니다.3개의 convolution-batchnorm-ReLU 블록을 지정합니다.
Padding옵션을"same"으로 설정하여 컨벌루션 계층의 입력값에 채우기를 수행하여, 출력값이 동일한 크기가 되도록 합니다.첫 번째 컨벌루션 계층에 크기가 5인 필터 20개를 지정합니다. 나머지 컨벌루션 계층에는 크기가 3인 필터 20개를 지정합니다.
분류를 위해 클래스 개수와 일치하는 크기의 완전 연결 계층을 지정합니다.
출력값을 확률에 매핑하기 위해 소프트맥스 계층을 포함시킵니다.
사용자 지정 훈련 루프를 사용하여 신경망을 훈련시키는 경우 출력 계층을 포함시키지 마십시오.
layers = [
    imageInputLayer(inputSize,Normalization="none")
    convolution2dLayer(5,20,Padding="same")
    batchNormalizationLayer
    reluLayer
    convolution2dLayer(3,20,Padding="same")
    batchNormalizationLayer
    reluLayer
    convolution2dLayer(3,20,Padding="same")
    batchNormalizationLayer
    reluLayer
    fullyConnectedLayer(numClasses)
    softmaxLayer];
계층 배열에서 dlnetwork 객체를 만듭니다.
net = dlnetwork(layers)
net =
  dlnetwork with properties:

         Layers: [12×1 nnet.cnn.layer.Layer]
    Connections: [11×2 table]
     Learnables: [14×3 table]
          State: [6×3 table]
     InputNames: {'imageinput'}
    OutputNames: {'softmax'}
    Initialized: 1

  View summary with summary.
모델 손실 함수 정의하기
심층 신경망을 훈련시키는 것은 최적화 작업입니다. 신경망을 함수 (가 신경망 입력값이고 가 학습 가능한 파라미터 세트임)로 취급하면, 훈련 데이터를 바탕으로 어떤 손실 값을 최소화하도록 를 최적화할 수 있습니다. 예를 들어, 주어진 입력값 와 이에 대응하는 목표값 에 대해 예측값 와 간의 오차를 최소화하도록 학습 가능한 파라미터 를 최적화할 수 있습니다.
modelLoss 함수를 정의합니다. modelLoss 함수는 dlnetwork 객체 net와, 입력 데이터 X 및 이에 대응하는 목표값 T의 미니 배치를 받습니다. 그리고 손실, net의 학습 가능한 파라미터에 대한 손실의 기울기 및 신경망 상태를 반환합니다. 기울기를 자동으로 계산하기 위해 dlgradient 함수를 사용합니다.
function [loss,gradients,state] = modelLoss(net,X,T)

% Forward data through network.
[Y,state] = forward(net,X);

% Calculate cross-entropy loss.
loss = crossentropy(Y,T);

% Calculate gradients of loss with respect to learnable parameters.
gradients = dlgradient(loss,net.Learnables);

end
SGD 함수 정의하기
함수 sgdStep을 만듭니다. 이 함수는 파라미터와 파라미터에 대한 손실의 기울기를 받고, 로 표현되는 확률적 경사하강법 알고리즘을 사용하여 업데이트된 파라미터를 반환합니다. 여기서 는 반복 횟수, 는 학습률, 은 기울기(학습 가능한 파라미터에 대한 손실의 도함수)입니다.
function parameters = sgdStep(parameters,gradients,learnRate)

parameters = parameters - learnRate .* gradients;

end
사용자 지정 업데이트 함수를 정의하는 것은 사용자 지정 훈련 루프에 필요한 단계는 아닙니다. 그 대신에 sgdmupdate, adamupdate, rmspropupdate 같은 내장 업데이트 함수를 사용할 수 있습니다.
훈련 옵션 지정하기
미니 배치 크기 128, 학습률 0.01로 Epoch 15회만큼 훈련시킵니다.
numEpochs = 15;
miniBatchSize = 128;
learnRate = 0.01;
모델 훈련시키기
훈련시키는 동안 영상의 미니 배치를 처리하고 관리하는 minibatchqueue 객체를 만듭니다. 각 미니 배치에 대해 다음을 수행합니다.
사용자 지정 미니 배치 전처리 함수
preprocessMiniBatch(이 예제의 마지막 부분에 정의되어 있음)를 사용하여 목표값을 one-hot 형식으로 인코딩된 벡터로 변환합니다.각각 공간(spatial), 공간(spatial), 채널(channel), 배치(batch)를 뜻하는 차원 레이블
"SSCB"를 사용하여 영상 데이터의 형식을 지정합니다. 기본적으로minibatchqueue객체는 기본 유형single을 사용하여 데이터를dlarray객체로 변환합니다. 목표값의 형식은 지정하지 않습니다.부분 미니 배치는 버립니다.
사용 가능한 GPU가 있으면 GPU에서 훈련시킵니다. 사용 가능한 GPU가 있으면
minibatchqueue객체는 기본적으로 각 출력값을gpuArray로 변환합니다. GPU를 사용하려면 Parallel Computing Toolbox™와 지원되는 GPU 장치가 필요합니다. 지원되는 장치에 대한 자세한 내용은 GPU 연산 요구 사항 (Parallel Computing Toolbox) 항목을 참조하십시오.
mbq = minibatchqueue(augimdsTrain,...
    MiniBatchSize=miniBatchSize,...
    MiniBatchFcn=@preprocessMiniBatch,...
    MiniBatchFormat=["SSCB" ""], ...
    PartialMiniBatch="discard");
훈련 진행 상황 모니터의 총 반복 횟수를 계산합니다.
numObservationsTrain = numel(imdsTrain.Files);
numIterationsPerEpoch = floor(numObservationsTrain / miniBatchSize);
numIterations = numEpochs * numIterationsPerEpoch;
TrainingProgressMonitor 객체를 초기화합니다. monitor 객체를 생성할 때 타이머가 시작되므로 이 객체를 훈련 루프와 가깝게 생성해야 합니다.
monitor = trainingProgressMonitor( ...
    Metrics="Loss", ...
    Info="Epoch", ...
    XLabel="Iteration");
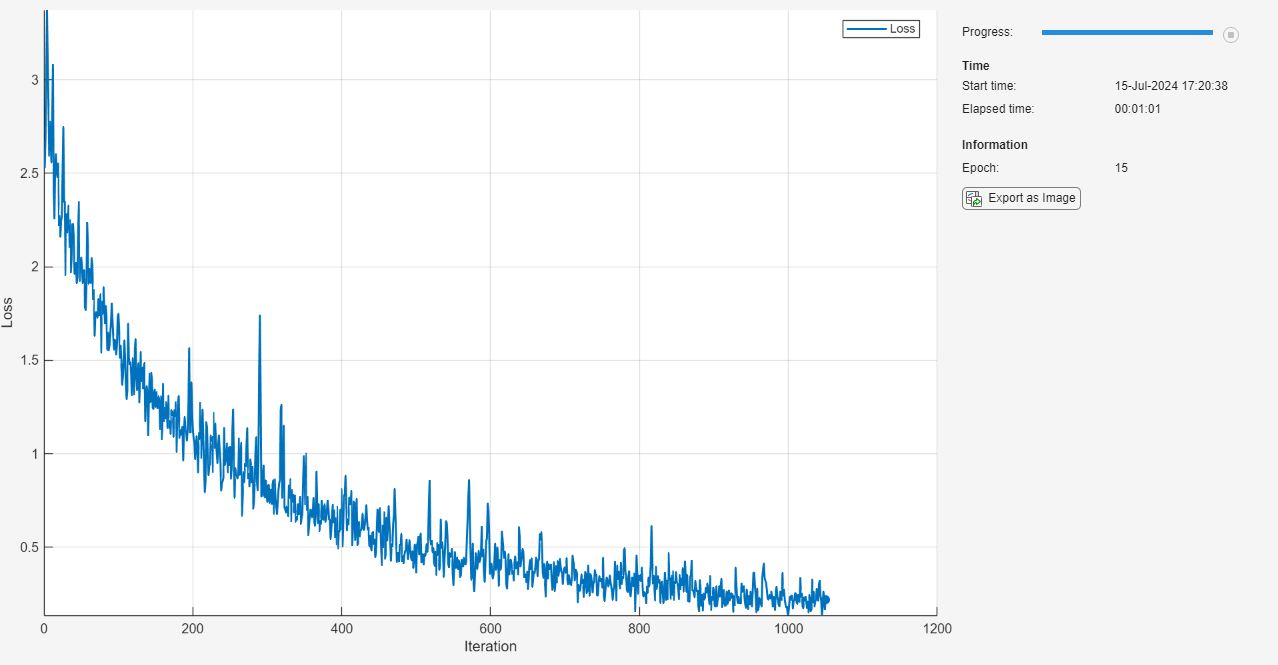
사용자 지정 훈련 루프를 사용하여 신경망을 훈련시킵니다. 각 Epoch마다 데이터를 섞고 루프를 사용해 데이터의 미니 배치를 순회합니다. 각 미니 배치에 대해 다음을 수행합니다.
dlfeval함수와modelLoss함수를 사용하여 모델의 손실, 기울기, 상태를 평가하고 신경망 상태를 업데이트합니다.사용자 지정 업데이트 함수에
dlupdate함수를 사용하여 신경망 파라미터를 업데이트합니다.훈련 진행 상황 모니터에서 손실 값과 Epoch 값을 업데이트합니다.
모니터의 Stop 속성이 true이면 중지합니다. 중지 버튼을 클릭하면
TrainingProgressMonitor객체의 Stop 속성값이 true로 변경됩니다.
epoch = 0;
iteration = 0;

% Loop over epochs.
while epoch < numEpochs && ~monitor.Stop

    epoch = epoch + 1;

    % Shuffle data.
    shuffle(mbq);

    % Loop over mini-batches.
    while hasdata(mbq) && ~monitor.Stop

        iteration = iteration + 1;

        % Read mini-batch of data.
        [X,T] = next(mbq);

        % Evaluate the model gradients, state, and loss using dlfeval and the
        % modelLoss function and update the network state.
        [loss,gradients,state] = dlfeval(@modelLoss,net,X,T);
        net.State = state;

        % Update the network parameters using SGD.
        updateFcn = @(parameters,gradients) sgdStep(parameters,gradients,learnRate);
        net = dlupdate(updateFcn,net,gradients);

        % Update the training progress monitor.
        recordMetrics(monitor,iteration,Loss=loss);
        updateInfo(monitor,Epoch=epoch);
        monitor.Progress = 100 * iteration/numIterations;
    end
end
모델 테스트하기
testnet 함수를 사용하여 신경망을 테스트합니다. 단일 레이블 분류의 경우 정확도를 평가합니다. 정확도는 올바른 예측의 비율입니다. 기본적으로 testnet 함수는 GPU를 사용할 수 있으면 GPU를 사용합니다. 실행 환경을 수동으로 선택하려면 testnet 함수의 ExecutionEnvironment 인수를 사용하십시오.
accuracy = testnet(net,augimdsTest,"accuracy")accuracy = 96.3000
예측값을 혼동행렬 차트로 시각화합니다. minibatchpredict 함수를 사용하여 예측을 수행하고 scores2label 함수를 사용하여 분류 점수를 레이블로 변환합니다. 기본적으로 minibatchpredict 함수는 GPU를 사용할 수 있으면 GPU를 사용합니다. 실행 환경을 수동으로 선택하려면 minibatchpredict 함수의 ExecutionEnvironment 인수를 사용하십시오.
scores = minibatchpredict(net,augimdsTest);
YTest = scores2label(scores,classes);
예측값을 혼동행렬 차트로 시각화합니다.
TTest = imdsTest.Labels;
figure
confusionchart(TTest,YTest)
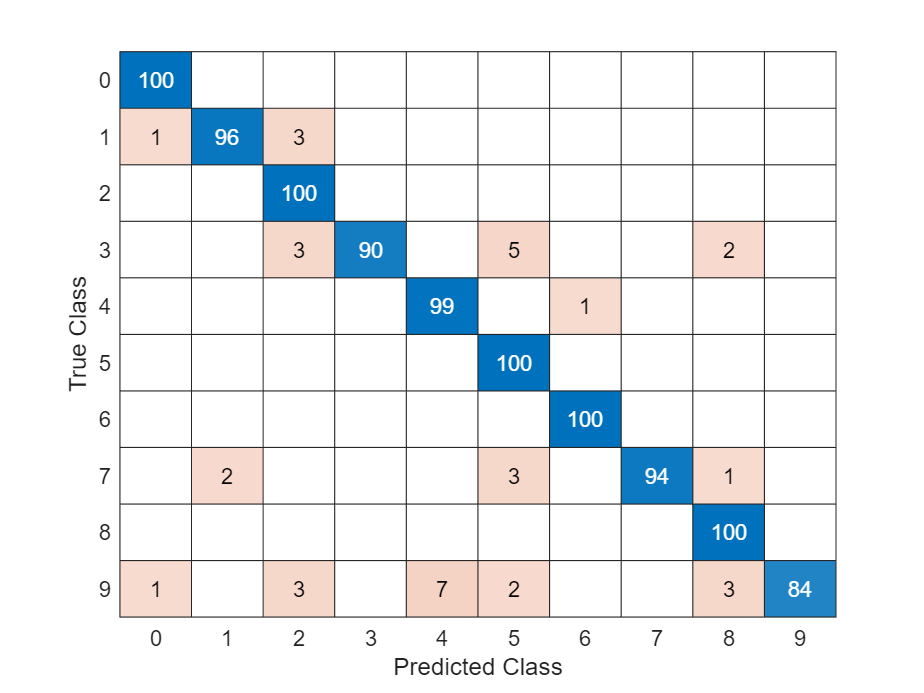
대각선에 있는 값이 크면 해당 클래스에 대한 예측이 정확함을 나타냅니다. 대각선을 벗어난 값이 크면 해당 클래스 간의 혼동이 심각함을 나타냅니다.
지원 함수
미니 배치 전처리 함수
preprocessMiniBatch 함수는 다음 단계를 사용하여 예측 변수와 레이블의 미니 배치를 전처리합니다.
preprocessMiniBatchPredictors함수를 사용하여 영상을 전처리합니다.입력되는 셀형 배열에서 레이블 데이터를 추출하여 두 번째 차원을 따라 categorical형 배열로 결합합니다.
categorical형 레이블을 숫자형 배열로 one-hot 형식으로 인코딩합니다. 첫 번째 차원으로 인코딩하면 신경망 출력값의 형태와 일치하는 인코딩된 배열이 생성됩니다.
function [X,T] = preprocessMiniBatch(dataX,dataT)

% Preprocess predictors.
X = preprocessMiniBatchPredictors(dataX);

% Extract label data from cell and concatenate.
T = cat(2,dataT{:});

% One-hot encode labels.
T = onehotencode(T,1);

end
미니 배치 예측 변수 전처리 함수
preprocessMiniBatchPredictors 함수는 입력 셀형 배열에서 영상 데이터를 추출한 후 숫자형 배열로 결합하여 예측 변수의 미니 배치를 전처리합니다. 회색조 입력값의 경우 네 번째 차원으로 결합하면 각 영상에 세 번째 차원이 추가되어 한원소 채널 차원으로 사용됩니다.
function X = preprocessMiniBatchPredictors(dataX)

% Concatenate.
X = cat(4,dataX{:});

end

