주요 콘텐츠

이 번역 페이지는 최신 내용을 담고 있지 않습니다. 최신 내용을 영문으로 보려면 여기를 클릭하십시오.

mad

R2025b

평균절대편차 또는 중앙값절대편차

설명

y = mad(X)는 X에 있는 값의 평균절대편차를 반환합니다.

  • X가 벡터이면 mad는 X에 있는 값의 평균절대편차 또는 중앙값절대편차를 반환합니다.

  • X가 행렬이면 mad는 X의 각 열에 대한 평균절대편차 또는 중앙값절대편차를 포함하는 행 벡터를 반환합니다.

  • X가 다차원 배열이면 mad는 X의 첫 번째 비한원소 차원을 따라 연산을 수행합니다.

예제

y = mad(X,flag)는 평균절대편차(flag = 0, 디폴트 값)를 계산할지 또는 중앙값절대편차(flag = 1)를 계산할지를 지정합니다.

예제

y = mad(X,flag,'all')은 X에 있는 모든 요소의 평균절대편차 또는 중앙값절대편차를 반환합니다.

예제

y = mad(X,flag,dim)은 X의 연산 차원 dim을 따라 평균절대편차 또는 중앙값절대편차를 반환합니다.

예제

y = mad(X,flag,vecdim)은 벡터 vecdim에 지정된 차원을 따라 평균절대편차 또는 중앙값절대편차를 반환합니다. 예를 들어 X가 2×3×4 배열이면 mad(X,0,[1 2])는 1×1×4 배열을 반환합니다. 출력 배열의 각 요소는 X의 대응되는 페이지에 있는 요소의 평균절대편차입니다.

예제

예제

모두 축소

이상값이 있을 때 표준편차, 평균절대편차, 중앙값절대편차의 견고성을 비교합니다.

정규분포된 데이터의 데이터 세트 x를 만듭니다. x의 요소와 추가적인 이상값을 포함하는 또 다른 데이터 세트 xo를 만듭니다.

rng('default') % For reproducibility
x = normrnd(0,1,1,50);
xo = [x 10];

두 데이터 세트의 표준편차의 비율을 계산합니다.

r1 = std(xo)/std(x)
r1 = 
1.4633

두 데이터 세트의 평균절대편차의 비율을 계산합니다.

r2 = mad(xo)/mad(x)
r2 = 
1.1833

두 데이터 세트의 중앙값절대편차의 비율을 계산합니다.

r3 = mad(xo,1)/mad(x,1)
r3 = 
1.0336

이 경우, 중앙값절대편차는 다른 두 스케일 추정값에 비해 이상값의 영향을 덜 받습니다.

배열에 있는 모든 값의 평균절대편차와 중앙값절대편차를 구합니다.

3×5×2 배열 X를 만들고 하나의 이상값을 추가합니다.

X = reshape(1:30,[3 5 2]);
X(6) = 100
X = 
X(:,:,1) =

     1     4     7    10    13
     2     5     8    11    14
     3   100     9    12    15


X(:,:,2) =

    16    19    22    25    28
    17    20    23    26    29
    18    21    24    27    30

X에 있는 요소의 평균절대편차와 중앙값절대편차를 구합니다.

meandev = mad(X,0,'all')
meandev = 
10.1178
mediandev = mad(X,1,'all')
mediandev = 
7.5000

meandev는 X에 있는 모든 요소의 평균절대편차이고 mediandev는 X에 있는 모든 요소의 중앙값절대편차입니다.

다차원 배열에 대해 서로 다른 차원을 따라 중앙값절대편차를 구합니다.

결과 재현이 가능하도록 난수 시드값을 설정합니다.

rng('default') 

난수로 구성된 1×3×2 배열을 만듭니다.

X = randn([1,3,2])
X = 
X(:,:,1) =

    0.5377    1.8339   -2.2588


X(:,:,2) =

    0.8622    0.3188   -1.3077

디폴트 차원을 따라 X의 중앙값절대편차를 구합니다.

Y2 = mad(X,1) % Flag is set to 1 for the median absolute deviation
Y2 = 
Y2(:,:,1) =

    1.2962


Y2(:,:,2) =

    0.5434

기본적으로 mad는 크기가 1이 아닌 X의 첫 번째 차원을 따라 계산됩니다. 여기서 이 차원은 X의 두 번째 차원입니다. 따라서 Y2는 1×1×2 배열입니다.

세 번째 차원을 따라 X의 중앙값절대편차를 구합니다.

Y3 = mad(X,1,3)
Y3 = 1×3

    0.1623    0.7576    0.4756

Y3은 1×3 행렬입니다.

vecdim 입력 인수를 사용하여 여러 차원을 따라 평균절대편차를 구합니다.

결과 재현이 가능하도록 난수 시드값을 설정합니다.

rng('default')

난수로 구성된 4×3×2 배열을 생성합니다.

X = randn([4 3 2])
X = 
X(:,:,1) =

    0.5377    0.3188    3.5784
    1.8339   -1.3077    2.7694
   -2.2588   -0.4336   -1.3499
    0.8622    0.3426    3.0349


X(:,:,2) =

    0.7254   -0.1241    0.6715
   -0.0631    1.4897   -1.2075
    0.7147    1.4090    0.7172
   -0.2050    1.4172    1.6302

첫 번째 차원과 두 번째 차원을 지정하여 X의 각 페이지에 대한 평균절대편차를 구합니다.

ypage = mad(X,0,[1 2])
ypage = 
ypage(:,:,1) =

    1.4626


ypage(:,:,2) =

    0.6652

예를 들어 ypage(:,:,2)는 X(:,:,2)에 포함된 모든 요소의 평균절대편차이며 mad(X(:,:,2),0,'all')을 지정하는 것과 동일합니다.

첫 번째 차원과 세 번째 차원을 지정하여 각 X(:,i,:) 슬라이스에 포함된 요소의 평균절대편차를 구합니다.

ycol = mad(X,0,[1 3])
ycol = 1×3

    0.8330    0.7872    1.5227

예를 들어 ycol(3)은 X(:,3,:)에 포함된 모든 요소의 평균절대편차이며 mad(X(:,3,:),0,'all')을 지정하는 것과 동일합니다.

입력 인수

모두 축소

모집단의 하나의 표본을 나타내는 입력 데이터로, 벡터, 행렬 또는 다차원 배열로 지정됩니다.

  • X가 벡터이면 mad는 X에 있는 값의 평균절대편차 또는 중앙값절대편차를 반환합니다.

  • X가 행렬이면 mad는 X의 각 열에 대한 평균절대편차 또는 중앙값절대편차를 포함하는 행 벡터를 반환합니다.

  • X가 다차원 배열이면 mad는 X의 첫 번째 비한원소 차원을 따라 연산을 수행합니다.

X가 행렬 또는 배열인 경우에 연산 차원을 지정하려면 dim 입력 인수를 사용하십시오.

mad는 NaNs를 누락값으로 처리하여 제거합니다.

데이터형: single | double

편차 유형에 대한 표시자로, 0 또는 1로 지정됩니다.

  • flag가 0(디폴트 값)이면 mad는 평균절대편차 mean(abs(X – mean(X)))를 계산합니다.

  • flag가 1이면 mad는 중앙값절대편차 median(abs(X – median(X)))를 계산합니다.

데이터형: single | double | logical

연산을 수행할 차원으로, 양의 정수로 지정됩니다. dim의 값을 지정하지 않으면 디폴트 값은 크기가 1이 아닌 X의 첫 번째 차원이 됩니다.

행렬 X의 평균절대편차를 살펴보겠습니다.

  • dim이 1이면 mad(X)는 X의 각 열에 대한 평균절대편차를 포함하는 행 벡터를 반환합니다.

  • dim이 2이면 mad(X)는 X의 각 행에 대한 평균절대편차를 포함하는 열 벡터를 반환합니다.

데이터형: single | double
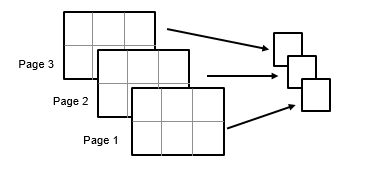
차원의 벡터로, 양의 정수 벡터로 지정됩니다. vecdim의 각 요소는 입력 배열 X의 차원을 나타냅니다. 출력값 y는 지정된 연산 차원에서 길이가 1입니다. 다른 차원 길이는 X 및 y에서 같습니다.

예를 들어 X가 2×3×3 배열이면 mad(X,0,[1 2])는 1×1×3 배열을 반환합니다. 출력 배열의 각 요소는 X의 대응되는 페이지에 있는 요소의 평균절대편차입니다.

Mapping of input dimension of 2-by-3-by-3 to output dimension of 1-by-1-by-3

데이터형: single | double

출력 인수

모두 축소

평균절대편차 또는 중앙값절대편차로, 스칼라, 벡터, 행렬 또는 다차원 배열로 반환됩니다. flag가 0(디폴트 값)이면 y는 X에 있는 값의 평균절대편차 mean(abs(X – mean(X)))입니다. flag가 1이면 y는 X에 있는 값의 중앙값절대편차 median(abs(X – median(X)))입니다.

팁

  • 정규분포된 데이터에서 정규 스케일 모수 σ의 추정값을 구하려면 mad에 다음 인자 중 하나를 곱하십시오.

    • sigma = 1.253 * mad(X,0) — 평균절대편차의 경우

    • sigma = 1.4826 * mad(X,1) — 중앙값절대편차의 경우

알고리즘

모두 축소

참고 문헌

[1] Mosteller, F., and J. Tukey. Data Analysis and Regression. Upper Saddle River, NJ: Addison-Wesley, 1977.

[2] Sachs, L. Applied Statistics: A Handbook of Techniques. New York: Springer-Verlag, 1984, p. 253.

확장 기능

모두 확장

버전 내역

R2006a 이전에 개발됨

참고 항목

| |