상관관계가 있는 변수를 식별하고 시각화하기
R2026b데이터 변수 간의 관계를 분석할 때, 상관관계가 있는 변수를 식별하고 시각화하면 데이터 세트에 대한 중요한 정보를 얻을 수 있습니다. 이 예제에서는 corrcoef 함수를 사용해 상관 계수를 계산하여 관계의 강도와 방향을 확인하는 방법을 보여줍니다. 상관 계수의 범위는 –1에서 1 사이입니다. 여기서,
값이 1에 가까우면 데이터 변수 간에 양의 선형 관계가 있음을 나타냅니다.
값이 –1에 가까우면 데이터 변수 간에 음의 선형 관계(반 상관관계)가 있음을 나타냅니다.
값이 0에 가깝거나 0이면 데이터 변수 간에 선형 관계가 없음을 암시합니다.
또한 이 예제에서는 어떤 상관관계가 유의미한지 확인하고 상관관계가 가장 높은 쌍을 식별하는 방법을 보여줍니다. 이 예제에서는 히트맵과 막대 차트로 상관관계를 플로팅하여 변수 간의 관계를 시각적으로 비교할 수 있습니다.
상관 계수와 p-값 계산하기
변수 간에 상관관계가 있는 임의의 데이터를 생성합니다. 그런 다음 corrcoef 함수를 사용하여 상관 계수와 상관관계의 유의성을 나타내는 해당 p-값을 계산합니다.
rng(16)
A = randn(50,6);
A(:,3) = A(:,3) + 2*A(:,1);
A(:,4) = A(:,4) - 3*A(:,2);
A(:,5) = A(:,6) + 0.1*A(:,4) - 0.1*A(:,3);
[R,P] = corrcoef(A)
R = 6×6

    1.0000   -0.1248    0.8047    0.1300   -0.1726   -0.1009
   -0.1248    1.0000   -0.0744   -0.9612   -0.2314    0.0730
    0.8047   -0.0744    1.0000    0.0709   -0.3595   -0.2515
    0.1300   -0.9612    0.0709    1.0000    0.2611   -0.0549
   -0.1726   -0.2314   -0.3595    0.2611    1.0000    0.9384
   -0.1009    0.0730   -0.2515   -0.0549    0.9384    1.0000
P = 6×6

    1.0000    0.3878    0.0000    0.3683    0.2308    0.4858
    0.3878    1.0000    0.6075    0.0000    0.1060    0.6143
    0.0000    0.6075    1.0000    0.6248    0.0103    0.0781
    0.3683    0.0000    0.6248    1.0000    0.0670    0.7051
    0.2308    0.1060    0.0103    0.0670    1.0000    0.0000
    0.4858    0.6143    0.0781    0.7051    0.0000    1.0000
반환되는 행렬 R과 P는 각각 상관 계수와 p-값을 포함하며, 두 행렬은 대칭 행렬입니다. 고유한 쌍별 상관관계에 중점을 두기 위해 R의 하부 삼각 부분을 추출합니다.
R = tril(R,-1)
R = 6×6

         0         0         0         0         0         0
   -0.1248         0         0         0         0         0
    0.8047   -0.0744         0         0         0         0
    0.1300   -0.9612    0.0709         0         0         0
   -0.1726   -0.2314   -0.3595    0.2611         0         0
   -0.1009    0.0730   -0.2515   -0.0549    0.9384         0
히트맵을 사용하여 상관관계 시각화하기
상관 계수의 히트맵을 생성하여 변수 간 관계의 강도와 방향을 시각화합니다.
상관 계수 행렬에서 하부 삼각 상관관계의 중복된 요소를 나타내는 0을 누락값(NaN)으로 변환합니다. 다음으로, 음의 상관관계를 갖는 변수 쌍은 빨간색, 양의 상관관계를 갖는 쌍은 파란색, 상관관계가 없는 쌍은 흰색으로 표시되는 컬러맵을 생성합니다. 히트맵은 가장 강한 상관관계를 밝은 빨간색과 밝은 파란색으로 강조 표시합니다.
Rheatmap = standardizeMissing(R,0);
map = [1 0 0;
    0.9 0.3 0.3;
    0.9 0.6 0.6;
    1 1 1;
    0.6 0.6 0.9;
    0.3 0.3 0.9;
    0 0 1];
h = heatmap(Rheatmap,Colormap=map,ColorLimits=[-1 1]);
h.Title = "Correlation Coefficients";
h.YLabel = "First Variable";
h.XLabel = "Second Variable";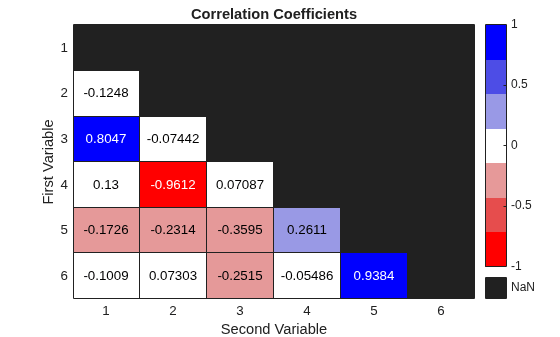
유의미한 상관관계 확인하기
p-값이 0.05보다 큰 상관관계를 필터링하여 유의미한 상관관계를 식별합니다. 이 접근 방식은 통계적으로 의미 있는 관계에만 집중해 분석하고, 랜덤 잡음을 상관관계로 해석하는 것을 방지합니다.
threshold = 0.05;
R(abs(P) > threshold) = 0;
[firstVar,secondVar,corrCoef] = find(R)
firstVar = 4×1

     3
     4
     5
     6
secondVar = 4×1

     1
     2
     3
     5
corrCoef = 4×1

    0.8047
   -0.9612
   -0.3595
    0.9384
상관관계를 테이블로 표시하기
인덱스, 상관 계수, p-값을 포함하여 유의미한 상관관계를 테이블로 작성합니다.
ind2 = sub2ind(size(P),firstVar,secondVar);
sigP = P(ind2);
TSig = table(firstVar,secondVar,corrCoef,sigP)
TSig = 4×4 table
    firstVar    secondVar    corrCoef       sigP
    ________    _________    ________    __________

       3            1         0.80471    1.8997e-12
       4            2        -0.96118    1.7065e-28
       5            3        -0.35949      0.010346
       6            5          0.9384    8.5819e-24
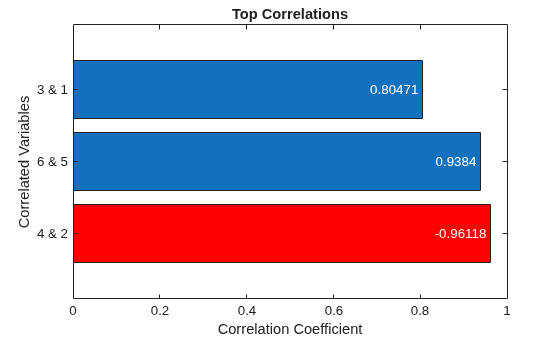
크기를 기준으로 상위 세 개의 상관관계를 나열합니다. 상위 상관관계가 입력 데이터에 설정된 관계와 일치합니다.
A(:,3) = A(:,3) + 2*A(:,1);
A(:,4) = A(:,4) - 3*A(:,2);
A(:,5) = A(:,6) + 0.1*A(:,4) - 0.1*A(:,3);
k = 3;
TTopk = topkrows(TSig,k,"corrCoef","descend",ComparisonMethod="abs")
TTopk = 3×4 table
    firstVar    secondVar    corrCoef       sigP
    ________    _________    ________    __________

       4            2        -0.96118    1.7065e-28
       6            5          0.9384    8.5819e-24
       3            1         0.80471    1.8997e-12
막대 차트를 사용하여 상위 상관관계 시각화하기
가로 막대 차트를 사용하여 가장 유의미한 3개의 상관관계를 표시합니다. 음의 상관관계는 빨간색 막대로 나타내고, 양의 상관관계는 파란색 막대로 나타냅니다.
labels = TTopk.firstVar + " & " + TTopk.secondVar;
b = barh(labels,abs(TTopk.corrCoef));

negCorr = TTopk.corrCoef < 0;
b.FaceColor = "flat";
b.CData(negCorr,:) = repmat([1 0 0],nnz(negCorr),1);
b.Labels = TTopk.corrCoef;
b.LabelLocation = "end-inside";

title("Top Correlations")
xlabel("Correlation Coefficient")
ylabel("Correlated Variables")