주요 콘텐츠

trainAutoencoder

R2026b

(제거될 예정임) 오토인코더 훈련

trainAutoencoder 함수는 향후 릴리스에서 제거될 예정입니다. 자세한 내용은 레거시 신경망 코드를 dlnetwork 워크플로로 전환하기 항목을 참조하십시오.

코드 업데이트에 대한 자세한 지침은 버전 내역 항목을 참조하십시오.

설명

autoenc = trainAutoencoder(X)는 X의 훈련 데이터를 사용하여 훈련된 오토인코더 autoenc를 반환합니다.

예제

autoenc = trainAutoencoder(X,hiddenSize)는 은닉 표현 크기가 hiddenSize인 오토인코더 autoenc를 반환합니다.

autoenc = trainAutoencoder(___,Name=Value)는 위에 열거된 구문에 나와 있는 입력 인수 외에, 하나 이상의 이름-값 인수를 사용하여 옵션을 지정합니다. 예를 들어, GPU에서 훈련시키려면 UseGPU를 "on"으로 설정하십시오.

예제

모두 축소

샘플 데이터를 불러옵니다.

X = abalone_dataset;

X는 전복 껍데기 4,177개의 8가지 특성, 즉 성별(M, F, I(미숙 객체)), 길이, 지름, 높이, 전체 중량, 속살 중량, 내장 중량, 껍데기 중량을 정의하는 8×4,177 행렬입니다. 이 데이터셋에 대한 자세한 내용을 보려면 명령줄에 help abalone_dataset을 입력하십시오.

디폴트 설정으로 희소 오토인코더를 훈련시킵니다.

autoenc = trainAutoencoder(X);
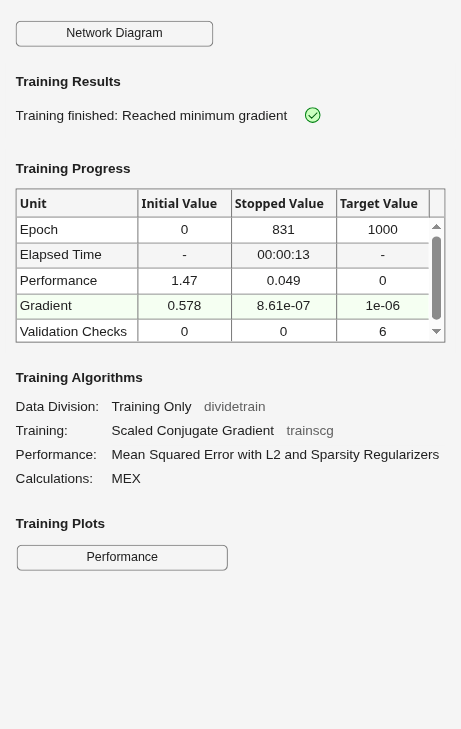
Figure Neural Network Training (07-Aug-2026 06:03:00) contains an object of type uigridlayout.

훈련된 오토인코더를 사용하여 전복 껍데기 나이테 데이터를 다시 생성합니다.

XReconstructed = predict(autoenc,X);

이 재구성에 대한 평균제곱오차를 계산합니다.

mseError = mse(X-XReconstructed)
mseError = 
0.0167

입력 인수

모두 축소

훈련 데이터로, 훈련 샘플로 구성된 행렬 또는 영상 데이터로 구성된 셀형 배열로 지정됩니다. X가 행렬인 경우, 각 열에는 하나의 샘플이 있습니다. X가 영상 데이터로 구성된 셀형 배열인 경우, 각 셀의 데이터는 차원 수가 같아야 합니다. 영상 데이터는 회색조 영상의 픽셀 명암 값일 수 있으며, 이 경우 각 셀에는 하나의 m×n 행렬이 있습니다. 영상 데이터는 RGB 데이터일 수도 있으며, 이 경우 각 셀에는 하나의 m×n×3 행렬이 있습니다.

데이터형: single | double | cell

오토인코더의 은닉 표현 크기로, 양의 정수 값으로 지정됩니다. 이 수치는 은닉 계층에 있는 뉴런의 개수입니다.

데이터형: single | double

이름-값 인수

모두 축소

선택적 인수 쌍을 Name1=Value1,...,NameN=ValueN으로 지정합니다. 여기서 Name은 인수 이름이고 Value는 대응값입니다. 이름-값 인수는 다른 인수 뒤에 와야 하지만, 인수 쌍의 순서는 상관없습니다.

R2021a 이전 릴리스에서는 쉼표를 사용하여 각 이름과 값을 구분하고 Name을 따옴표로 묶으십시오.

예: EncoderTransferFunction="satlin",L2WeightRegularization=0.05는 인코더의 전달 함수를 양의 포화 선형 전달 함수로 지정하고 L2 가중치 정규화를 0.05로 지정합니다.

인코더의 전달 함수로, 다음 표에 나열된 값 중 하나로 지정됩니다.

전달 함수 옵션정의
"logsig"

로지스틱 시그모이드 함수

f(z)=11+e−z

"satlin"

양의 포화 선형 전달 함수

f(z)={0,if  z≤0z,if  0<z<11,if  z≥1

이 인수는 출력 Autoencoder 객체의 EncoderTransferFunction 훈련 파라미터 속성을 문자형 벡터로 설정합니다.

예: EncoderTransferFunction="satlin"

디코더의 전달 함수로, 다음 표에 나열된 값 중 하나로 지정됩니다.

전달 함수 옵션정의
"logsig"

로지스틱 시그모이드 함수

f(z)=11+e−z

"satlin"

양의 포화 선형 전달 함수

f(z)={0,if  z≤0z,if  0<z<11,if  z≥1

"purelin"

선형 전달 함수

f(z)=z

이 인수는 출력 Autoencoder 객체의 DecoderTransferFunction 훈련 파라미터 속성을 문자형 벡터로 설정합니다.

예: DecoderTransferFunction="purelin"

최대 훈련 Epoch 횟수 또는 반복 횟수로, 양의 정수 값으로 지정됩니다.

예: MaxEpochs=1200

비용 함수(LossFunction)에서 L2 가중치 정규화 함수의 계수로, 양의 스칼라 값으로 지정됩니다.

예: L2WeightRegularization=0.05

훈련에 사용할 손실 함수로, "msesparse"로 지정됩니다. 다음과 같이 희소 오토인코더를 훈련시키기 위해 조정된 평균제곱오차 함수에 해당됩니다.

E=1N∑n=1N∑k=1K(xkn−x^kn)2︸mean squared error+λ*Ωweights︸L2regularization+β*Ωsparsity︸sparsityregularization,

여기서 λ는 L2 정규화 항의 계수이고 β는 희소 정규화 항의 계수입니다. 오토인코더를 훈련시키는 중에 L2WeightRegularization과 SparsityRegularization 이름-값 인수를 사용하여 각각 λ와 β의 값을 지정할 수 있습니다.

이 인수는 출력 Autoencoder 객체의 LossFunction 훈련 파라미터 속성을 문자형 벡터로 설정합니다.

훈련 창을 표시할지 여부 표시자로, 숫자형 또는 논리값 1(true) 또는 0(false)으로 지정됩니다.

예: ShowProgressWindow=false

뉴런이 응답하도록 할 훈련 표본의 비율로, 양의 스칼라 값으로 지정됩니다. 희소 비율은 희소 정규화 함수의 파라미터입니다. 은닉 계층의 출력값의 희소 정도를 제어합니다. 일반적으로 SparsityProportion의 값이 작으면 은닉 계층의 각 뉴런이 적은 수의 훈련 표본에 대해서만 높은 출력값을 부여함으로써 "특화"됩니다. 따라서 희소 비율이 낮으면 높은 희소성이 유발됩니다.

예: SparsityProportion=0.01은 은닉 계층의 각 뉴런이 훈련 표본에 대해 평균 출력값 0.1을 가져야 한다고 지정하는 것과 같습니다.

비용 함수에서 희소 정규화 함수의 영향력을 제어하는 계수로, 양의 스칼라 값으로 지정됩니다.

예: SparsityRegularization=1.6

오토인코더를 훈련시키는 데 사용할 알고리즘으로, "trainscg"로 지정됩니다. scg는 스케일링된 켤레 경사하강법(scaled conjugate gradient descent) [1]을 나타냅니다.

이 인수는 출력 Autoencoder 객체의 TrainingAlgorithm 훈련 파라미터 속성을 문자형 벡터로 설정합니다.

입력 데이터를 다시 스케일링할지 여부 표시자로, 숫자형 또는 논리값 1(true) 또는 0(false)으로 지정됩니다.

오토인코더는 출력값으로 입력값과 똑같은 값을 만들어내려는 시도를 합니다. 이것이 가능하려면 입력 데이터의 범위가 디코더에 대한 전달 함수의 범위와 일치해야 합니다. trainAutoencoder는 오토인코더를 훈련시킬 때 훈련 데이터를 자동으로 이 범위로 스케일링합니다. 오토인코더를 훈련시킬 때 데이터가 스케일링된 경우, predict, encode, decode 메서드도 데이터를 스케일링합니다.

예: ScaleData=false

훈련에 GPU를 사용하기 위한 옵션으로, 다음 값 중 하나로 지정됩니다.

  • "off" — 로컬 CPU를 사용합니다.

  • "on" — 로컬 GPU를 사용합니다.

  • "auto" — 사용 가능한 로컬 GPU가 있으면 이를 사용합니다. 그렇지 않은 경우 로컬 CPU를 사용합니다.

MATLAB®에서 계산을 가속화하기 위해 GPU를 사용하려면 Parallel Computing Toolbox™와 지원되는 GPU 장치가 필요합니다. 지원되는 장치에 대한 자세한 내용은 GPU 연산 요구 사항 (Parallel Computing Toolbox) 항목을 참조하십시오.

R2026a 이전: UseGPU 옵션을 숫자형 또는 논리값 0(false) 또는 1(true)로 지정합니다. 이는 각각 "off" 및 "auto"에 해당합니다.

예: UseGPU="on"

출력 인수

모두 축소

훈련된 오토인코더로, Autoencoder 객체로 반환됩니다. 이 객체의 속성과 메서드에 대한 자세한 내용은 Autoencoder 클래스 페이지를 참조하십시오.

세부 정보

모두 축소

참고 문헌

[1] Moller, M. F. “A Scaled Conjugate Gradient Algorithm for Fast Supervised Learning”, Neural Networks, Vol. 6, 1993, pp. 525–533.

[2] Olshausen, B. A. and D. J. Field. “Sparse Coding with an Overcomplete Basis Set: A Strategy Employed by V1.” Vision Research, Vol.37, 1997, pp.3311–3325.

버전 내역

R2015b에 개발됨

모두 확장