이 번역 페이지는 최신 내용을 담고 있지 않습니다. 최신 내용을 영문으로 보려면 여기를 클릭하십시오.
문법적 종속 관계 구문 분석을 사용하여 문장 구조 분석하기
R2026a이 예제에서는 문법적 종속 관계 구문 분석을 사용하여 문장에서 정보를 추출하는 방법을 보여줍니다.
문법적 종속 관계 구문 분석은 문장의 단어 간 종속 관계를 강조 표시하여 문장의 구조를 식별하는 과정입니다. 예를 들어, 어떤 형용사가 어떤 명사를 수식하는지 나타낼 수 있습니다.
문법적 종속 관계 분석을 사용하여 문장에서 정보를 추출할 수 있습니다. 예를 들어, "파란 빛이 보이면 빨간색 버튼을 누르십시오."라는 문장의 문법적 세부 사항을 구문 분석하고 프로그래밍적으로 해당 문장에서 버튼이 빨간색이며 눌러야 한다는 정보를 얻을 수 있습니다.
다음 플롯은 문장의 문법 구조를 보여줍니다.
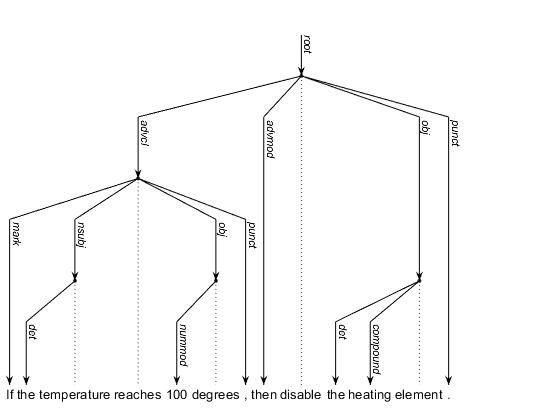
문법적 종속 관계 세부 정보 추가하기
분석할 문장을 포함하는 string형 스칼라를 만듭니다.
str = "If the temperature reaches 100 degrees, then disable the heating element.";텍스트를 토큰화하고 문서에 문법적 종속 관계를 추가합니다. addDependencyDetails 함수를 사용하려면 Text Analytics Toolbox™ Model for UDify Data 지원 패키지가 필요합니다. 이 지원 패키지가 설치되어 있지 않으면 함수에서 다운로드 링크를 제공합니다.
document = tokenizedDocument(str);
document = addDependencyDetails(document);
tokenDetails 함수를 사용하여 토큰 세부 정보를 표시합니다. addDependencyDetails 함수는 변수 Head와 Dependency를 테이블에 추가합니다.
tdetails = tokenDetails(document)
tdetails=13×8 table
    "If"    1    1    1    letters    en    4    mark
    "the"    1    1    1    letters    en    3    det
    "temperature"    1    1    1    letters    en    4    nsubj
    "reaches"    1    1    1    letters    en    9    advcl
    "100"    1    1    1    digits    en    6    nummod
    "degrees"    1    1    1    letters    en    4    obj
    ","    1    1    1    punctuation    en    4    punct
    "then"    1    1    1    letters    en    9    advmod
    "disable"    1    1    1    letters    en    0    root
    "the"    1    1    1    letters    en    12    det
    "heating"    1    1    1    letters    en    12    compound
    "element"    1    1    1    letters    en    9    obj
    "."    1    1    1    punctuation    en    9    punct
문법적 종속 관계 시각화하기
문법적 종속 관계를 문장 차트로 시각화합니다.
figure
sentenceChart(document)

문법적 종속 관계 트리에서 정보 추출하기
트리 구조를 사용하여 문장에서 정보를 추출할 수 있습니다.
문장의 형식은 "If <조건>, then <동작>."입니다.
문장의 루트(주동사)를 찾습니다. 여기에서 루트는 동작 부분에서의 동사인 "disable"입니다.
idxRoot = find(tdetails.Dependency == "root");
tokenRoot = tdetails.Token(idxRoot)
tokenRoot = "disable"
문장의 조건절을 구문 분석하기 위해 문장의 부사절을 찾습니다. 여기에서 부사절의 루트는 동사 "reaches"입니다.
idxRoot = find(tdetails.Dependency == "root");
idxAdvcl = (tdetails.Head == idxRoot) & (tdetails.Dependency == "advcl");

tokenAdvcl = tdetails.Token(idxAdvcl)
tokenAdvcl =
"reaches"
"<주어> reaches <목적어>," 형태의 하위절을 구문 분석하기 위해 단어 "reaches"의 주어와 목적어를 찾습니다.
단어 "reaches"의 명사 주어를 찾습니다. 여기에서 명사 주어는 단어 "temperature"입니다.
idxToken = find(tdetails.Token == "reaches");

idxNsubj = (tdetails.Head == idxToken) & (tdetails.Dependency == "nsubj");
tokenNsubj = tdetails.Token(idxNsubj)
tokenNsubj =
"temperature"
동사 "reaches"의 목적어를 찾습니다. 여기에서 목적어는 단어 "degrees"입니다.
idxToken = find(tdetails.Token == "reaches");

idxConditionObject = (tdetails.Head == idxToken) & (tdetails.Dependency == "obj");
tokenConditionObject = tdetails.Token(idxConditionObject)
tokenConditionObject =
"degrees"
"<숫자> degrees" 형태의 하위절을 구문 분석하기 위해 단어 "degrees"의 숫자 수식어를 찾습니다. 여기에서 숫자 수식어는 "100"입니다.
idxToken = find(tdetails.Token == "degrees");

idxNummod = (tdetails.Head == idxToken) & (tdetails.Dependency == "nummod");
tokenNummod = tdetails.Token(idxNummod)
tokenNummod =
"100"
문장의 동작을 구문 분석하기 위해 동사 "disable"의 목적어를 찾습니다. 여기에서 목적어는 단어 "element"입니다.
idxToken = find(tdetails.Token == "disable");

idxActionObject = (tdetails.Head == idxToken) & (tdetails.Dependency == "obj");
tokenActionObject = tdetails.Token(idxActionObject)
tokenActionObject =
"element"
"<유형> element." 형태의 하위절을 구문 분석하기 위해 복합 관계를 갖는 토큰을 찾습니다. 여기에서 수식어는 단어 "heating"입니다.
idxToken = find(tdetails.Token == "element");

idxObject = (tdetails.Head == idxToken) & (tdetails.Dependency == "compound");
tokenCompound = tdetails.Token(idxObject)
tokenCompound =
"heating"
참고 항목
sentenceChart | wordcloud | textscatter | addDependencyDetails | tokenDetails | addSentenceDetails | tokenizedDocument

